Aside 에이전트(영상 속 브라우저 에이전트)로 가입·등록을 돕고, Discord 경로로 더 빠른 접근을 시도했다고 한다.
초대 메일은 하룻밤 정도 뒤에 왔다고 본인 경험으로 말한다. 모든 사용자에게 같은 시간이 걸린다는 뜻이 아니다.
Aside가 API 키 생성을 도왔고, 문서를 Aside에 넣어 Jev 사용법을 학습시킨 뒤 스킬로 설치했다.
요점은 “채팅창에 Jev를 켠다”가 아니라, 코드·에이전트가 호출하는 판단 레이어라는 점이다.
패턴 2 — 맥락은 LLM·도구가 모으고, Jev는 긴급도·분기만 (Gmail)
Aside + Gmail 시연에서 메일 본문·스레드를 긁어 오는 쪽은 에이전트와 도구다. Jev에게는 회신 긴급도 Top 5 같은 순위·분기만 맡겼다. 크리에이터는 잊고 있던 급한 스레드가 위로 올라왔다고 보고한다.
게이트로 바꾸면 이렇게 나뉜다.
입력: 스레드 요약·발신자·마감·과거 맥락(도구가 수집)
Jev: 긴급도 점수·순위·“지금 답할지”
출력: 사람이 볼 짧은 리스트 (자동 발송이 아님)
패턴 3 — 모델 라우터 (수능 데모는 ‘예측 보고서’)
과거 수능 수학 문항을 넣고 “2027 예측” 보고서를 만드는 데모에서, Jev는 난이도·작업 종류를 판단하는 라우터로 쓰였다. 쉬운 문항 / 깊은 추론 / 서술(쓰기)을 서로 다른 생성 모델로 넘기는 식이다. 크리에이터는 라우터가 아직 미완이며 GitHub 공유를 검토한다고 했다.
중요. 보고서 자체도 실제 출제를 보장하지 않는다고 명시한다. moonlang도 “수능 적중”으로 읽히게 쓰지 않는다. 교육 상담이 필요하면 readmaster 안내를 보면 된다. 학원 CTA를 이 글에 늘리지 않는다.
투자 봇 예시 — 확률·현금 맥락; 따라 사지 말 것
Grok Bot / 투자 봇 시연에서는 LLM이 시장을 요약하고, Jev는 삼성·하이닉스에 대해 추가 매수 예/아니오와 확률만 판단했다. 현금·포지션 맥락이 결과에 영향을 줬다고 한다. 출력은 참고용으로 프레이밍됐다.
따라 사지 말 것. 이 절은 영상 속 아키텍처 메모일 뿐이다. 수익·수익률·추천을 주장하지 않는다. 투자 결정은 본인 책임이다.
moonlang에서 이미 쓰는 쪽
moonlang 쪽에서도 같은 결을 쓴다. 판단은 Jev(또는 동등한 게이트), 발행·실행은 코드다. claim-seal / content-route처럼 “이 문장을 올릴지 / 어느 파이프로 보낼지”를 구조화 질문으로 두고, 실제 게시·파일 쓰기는 스크립트가 맡는다. 비밀 경로·내부 키·운영 디테일은 이 글에 적지 않는다. API 튜토리얼 본문은 기존 가이드로 보낸다.
TypeSafe AI의 Jev는 긴 문장을 생성하는 채팅 모델이 아니라, 프로그램 상태(state)와 타입 있는 질문을 받아 선택·점수·예/아니오 확률을 돌려주는 System One 모델이다. 이 글은 공개 실전 가이드 How to Use Jev: A practical guide to TypeSafe’s System One model의 구조를 바탕으로, moonlang에 이미 올린 소개 초안(WP 1704)과 공식·언론 교차 확인 범위 안에서 설정·세 프리미티브·다섯 패턴·실패 모드·언제 쓸지만 정리한다.
숫자 주의. 지연·가격 배수·벤치마크·“출시 48시간 데모” 비용은 대부분 TypeSafe 또는 데모 작성자 보고다. 가이드 본문도 자사 측정·미재현을 전제로 한다. 아래에서는 그 한계를 반복해 표시한다.
한 줄로
Jev는 state + 질문(Choice / Score / Noul)을 한 요청에 넣고, 수십~수백 밀리초 구간의 구조화 답을 받는 쪽에 가깝다. 텍스트·코드·요약을 “쓰게” 하는 도구가 아니다. 싸게 분류·라우팅·게이트한 뒤, 필요한 소수만 큰 LLM이나 사람에게 넘기는 캐스케이드가 실무 기본형이다.
가이드 기준 기본 모델은 jev-latest, HTTP는 POST https://api.typesafe.ai/v1/systemone. 패키지명·환경 변수명은 배포 시점에 바뀔 수 있으니 공식 문서와 콘솔을 한 번 더 확인한다.
회사·게이트웨이 쪽에 반복되는 입력 단가는 약 $0.042 / 1M input tokens, 출력 토큰 무료 주장이다. (Vercel AI Gateway 모델 카드·공식 소개와 동일 계열. 지속 가능 여부는 회사가 “장기 과제”로 남긴 바 있다.)
세 프리미티브
API의 질문 타입은 세 가지가 전부다. 우회할 제한이 아니라 설계 자체다. (공식 Primitives 문서와 동일 계열)
Choice — 집합에서 하나
Choice(
    instructions="Which team should handle this",
    criteria={
        "billing":   "Payment or subscription issues",
        "technical": "Bugs or integration problems",
        "sales":     "Pricing or account questions",
    },
)
.choice, .probabilities, .confidence를 돌려준다. 가이드는 옵션을 최대 255개까지, 짧은 숏리스트보다 전체 목록을 넘기라고 한다. 맞는 게 없을 때를 위해 명시적 other를 넣으라고 권한다.
Score — 스펙트럼 위 위치
Score(
    instructions="How frustrated the customer appears",
    criteria=[
        "Calm, just stating facts",
        "Frustrated but civil",
        "Very angry, strong language",
    ],
)
2~10단계의 순서 있는 수준. .score는 단계 사이 값(예: 1.035)이 될 수 있고, 단계 인덱스는 배열 순서(0부터)다.
Noul — 예/아니오를 확률로
Noul(instructions="The message conveys urgency or time-sensitivity")
.noul은 0~1. 가이드 기준으로는 별도 confidence 필드가 없고, 숫자 자체가 믿음의 표현이다.
한 요청에 묶기
from typesafe_sdk import Choice, Noul, Score, TypeSafeClient

client = TypeSafeClient()
response = client.system_one(
    state={
        "ticket": {
            "subject": "Duplicate charge",
            "messages": [
                {"from": "customer",
                 "text": "I was charged twice for order A-104. Please refund the duplicate."},
            ],
        },
        "order": {"id": "A-104", "charges": [
            {"amount_usd": 49, "status": "captured"},
            {"amount_usd": 49, "status": "captured"},
        ]},
        "refund_policy": "Duplicate charges are eligible for a refund.",
    },
    questions={
        "department": Choice(
            instructions="Which team should handle this",
            criteria={"billing": "Payment or subscription issues",
                      "technical": "Bugs or integration problems",
                      "sales": "Pricing or account questions"}),
        "frustration": Score(
            instructions="How frustrated the customer appears",
            criteria=["Calm, just stating facts",
                      "Frustrated but civil",
                      "Very angry, strong language"]),
        "refund_requested": Noul(
            instructions="The customer is explicitly asking for a refund"),
        "policy_supports": Noul(
            instructions="The stated refund policy covers this situation"),
    },
)
TypeScript 가이드 예시도 같은 모양이다. state는 문자열·객체·문자열 배열. 이미지·오디오·비디오는 없고, 필요하면 먼저 전사·캡션한다. 가이드가 적는 컨텍스트 한도는 대략 state+질문 합 64k, state+가장 긴 질문 32k 토큰(문서·버전과 다를 수 있음).
훔칠 만한 다섯 패턴
1) Speculative fan-out
질문은 병렬이라, “싼 호출 먼저 → 필요할 때만 후속” 본능을 뒤집는다. 카테고리와 무관해 보이는 후속 질문도 같이 묻고, 코드가 어떤 답을 쓸지 고른다. 가이드가 인용하는 TypeSafe 쿡북 주장: 위키 장문 위에 13질문을 한 번에 묶으면, 하나씩 물을 때보다 약 12.2× 싸고 10.0× 빠르며 답은 동일 — 자사 쿡북 수치다.
2) Confidence-gated routing
가이드는 Jev가 RLCD(Reinforcement Learning for Calibrated Decisions)로 확률을 결과에 맞춘다고 설명한다. (공식 소개는 보정된 결정 학습을 채팅용 RLHF와 대비한다.) 그래서 전역 임계값 하나보다, 행동 비용별로 다른 막을 둔다. 잔액 조회는 낮게, 이체 승인은 높게. 분포가 평평하면 모델보다 criteria 설계 문제인 경우가 많다.
3) Composite scoring
“이 지원자 얼마나 좋은가” 한 방 대신, 파이썬 깊이·리더십·시스템 설계처럼 원자 Score를 나눈 뒤 가중 평균은 코드에서 한다. 가중치 변경이 재프롬프트가 아니라 코드 변경이 된다.
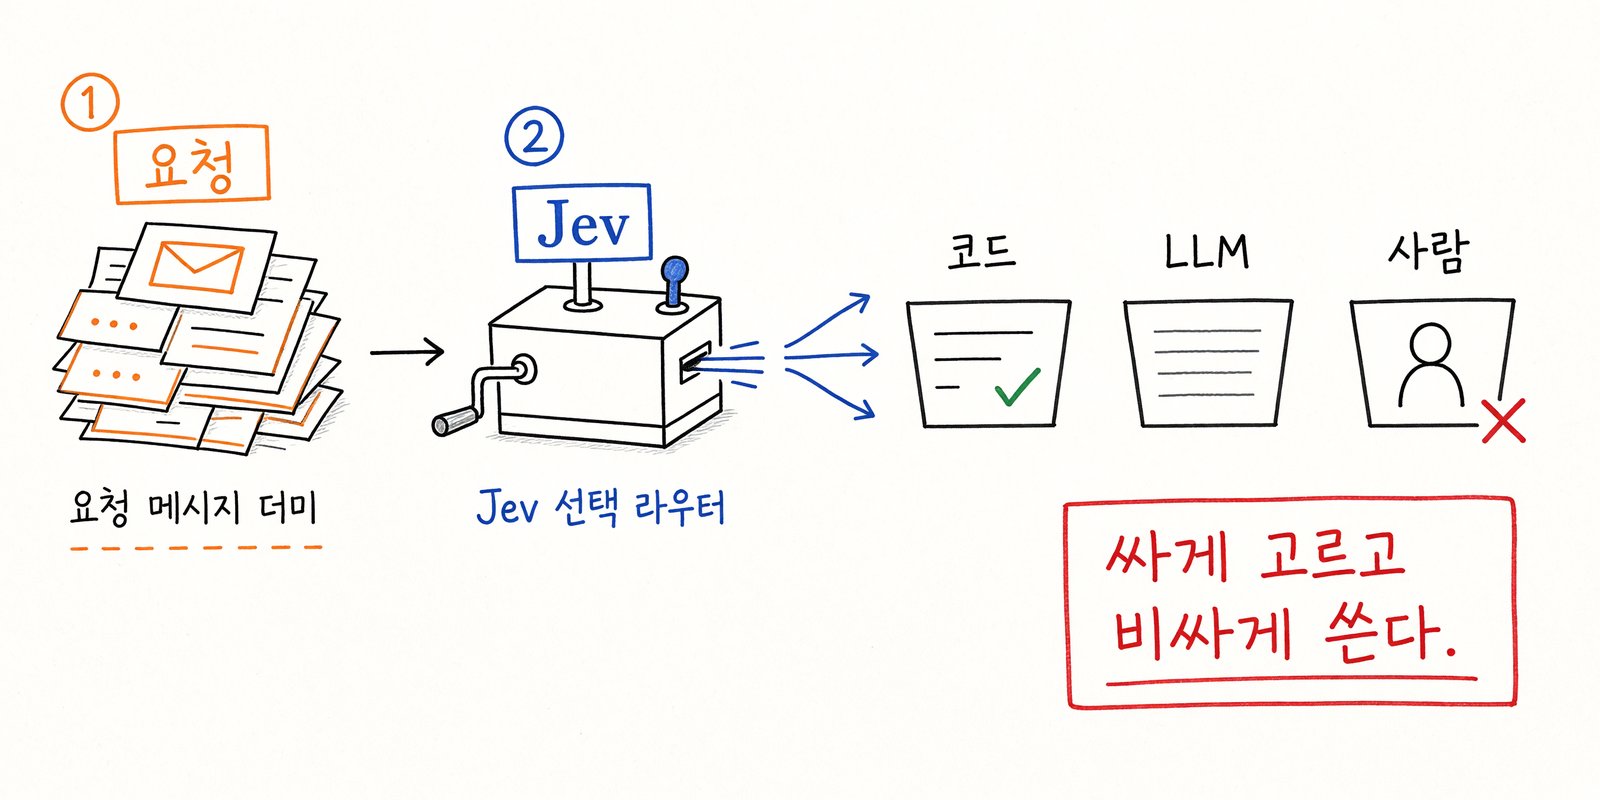
4) Cascade
AI로 제작한 Cascade 흐름 안내 이미지
Jev는 Opus/GPT급을 대체하지 않는다. 누가 큰 모델을 받을지를 값싸게 고른다. intent+complexity로 나눈 뒤, 순수 코드 / 전문 LLM / 사람 에스컬레이션으로 분기. 가이드의 백만 티켓 비용 예시($6,480 vs $30,400 등)는 TypeSafe per-case 가정에 따른 산술 — 재현·트래픽 전제 없이 그대로 믿으면 안 된다.
5) Retrieve, then judge
Jev는 넘겨준 state 밖의 세계를 모른다. 관련 없는 텍스트를 넣으면 정확도가 떨어진다고 jaggedness/문서 계열에서 경고한다. 검색·필터는 코드(또는 검색 API)로 하고, 논문·패시지마다 Noul/Score로 값싼 판정만 맡긴다. “잘 보정된 잘못된 자료에 대한 판단”이 나올 수 있다.
출시 직후 데모 (참고만)
가이드는 2026-09-15 론칭 이후 약 48시간 산출물을 모았다. 작성자 자기 보고이며 프로덕션 사례가 아니다. 패턴만 요약한다.
대량 논문: 생성 모델로 요약 + Jev Choice로 토픽 분류(비용 비대칭을 보여 주는 파이프라인).
브라우저/컴퓨터 사용: 페이지·OCR을 기호 상태로 압축한 뒤 Jev가 행동·타깃을 고르고, 텍스트 입력 등만 작은 생성 모델.
트레이딩·드론 등: 제어 루프·안전은 코드, Jev는 낮은 Hz의 전술 판단만.
공통점: 루프·안전·산술은 평범한 코드에 두고, 코드로 쓰기 어려운 좁은 판단만 Jev에 둔다.
실패 모드 (가이드·jaggedness 계열)
글자 그대로 읽는다. 부정·범위·암시 조건이 곧이곧대로 적용된다. 틀린 답을 보고 “내가 진짜 뜻한 말”을 설명하게 되면, 그 설명이 빠진 instruction이다.
계산기가 아니다. 세기·날짜 순서·창 안 여부 등은 약하다. 항목마다 Noul을 돌리거나, 날짜는 열거 Choice + “미기재”, 조립은 코드.
Context rot. 질문에 필요 없는 state가 늘수록 성능이 떨어진다. 먼저 회수·필터.
적대적 state. 사용자 통제 텍스트가 스스로를 변호하면 답이 움직인다. 위협 모델은 애플리케이션 몫.
모순된 criteria. true가 “아니오”를 뜻하는 Noul 등은 약해진다.
생성 없음. 텍스트·코드·요약 불가. 후보는 정규식/생성 모델로 뽑고 Jev가 고른다.
메타 규칙: 코드가 정확히 계산할 수 있는 것을 모델에 묻지 말고, 한 질문에 여러 판단을 숨기지 말 것.
운영 메모 (가이드 시점)
레이트 리밋 예시: jev-1.13 기준 초당 토큰·분당 요청 상한과 429 + SDK 백오프 — 용량에 따라 예고 없이 변할 수 있다고 TypeSafe가 경고.
임계값을 튜닝했다면 jev-latest 대신 버전 핀. 응답의 model 필드를 로그.
과금은 입력 중심·출력 무료 주장이라 speculative fan-out이 싸다는 논리다.
정직한 스코어카드
가이드가 인용하는 TypeSafe 4-워크플로 평가에서 Jev가 일부 프론티어와 비슷한 합의 점수·훨씬 낮은 비용/지연을 주장한다. 다만 (1) 정답이 아니라 두 프론티어 평균 레이블과의 합의도, (2) TypeSafe가 설계·실행한 자사 평가, (3) “환각 0%”는 스키마 밖 값을 못 낸다는 뜻이지 틀린 valid 답을 안 낸다는 뜻이 아님, (4) 가격 지속성은 증명되지 않음. 우리 트래픽으로 다시 재야 한다.
언제 쓰고 / 언제 안 쓰나
맞음: 라우팅·트리아지, 모더레이션, 비싼 컨텍스트 전 관련성 필터, LLM 출력 가드레일, 초저가 대량 태깅, 요청 핸들러 안 서브세컨드 판정.
아님: 생성 전반, 산술·카운트·날짜 연산, 감사 추적용 서술 근거가 필요한 결정, 열린 답 공간, 일회성 복잡한 추론.
싸진 LLM이 아니라, 타입을 반환하고 신뢰도를 말하는 함수 호출에 가깝다. 문자열 출력을 견디려고 쌓아 둔 파서·재시도 상당수를 걷어낼 수 있는지가 핵심 질문이다.
교육·문해력 쪽에서 보면
수업용 채팅봇 대체가 아니다. 다만 “한 방에 총평” 대신 기준을 Choice/Score/Noul로 쪼개고, 임계값 아래에서 사람이 개입하는 구조는 읽기 교육의 근거·판단 분리와 닮아 있다. 학생 산출물 자동 채점도 동일하게 문항 단위 판정 + 사람 게이트가 더 안전하다.
체크리스트
일이 유한 옵션·척도·예/아니오로 쪼개지는가.
틀린 결정을 잡을 임계값·에스컬레이션이 코드에 있는가.
산출물이 문장 자체면 LLM이 맞다.
state는 최소·근거 있는 소스만 — 검색은 앞에서.
가격·지연·한도는 PoC와 게이트웨이 카드로 재확인. early access·모델 버전 변경을 전제한다.
출처
실전 가이드 원문 구조: How to Use Jev: A practical guide to TypeSafe’s System One model (사용자 제공; ai/llm/tutorial 태그)
학원·학교에서 가장 흔한 스캔 요청 중 하나는 이것이다. “시험지·프린트에 쓴 필기를 지우고, 인쇄된 글자는 그대로 두고 싶다.” 시중 스캐너 앱은 곡면 보정·OCR에는 강하지만, 필기 제거 과정에서 인쇄 글자를 다시 그려 버리는 경우가 있다. 시험지 재사용에는 치명적이다.
ocr-scanner-fable 작업(제품 가칭 CleanScan / CleanScan)은 그 문제를 Web 우선 파이프라인으로 풀어 본 기록이다. 이 글은 기획서·마일스톤 로그에 남은 결정과 교훈만 요약한다. 벤치마크 앱의 다운로드 수 등은 기획 조사에 인용된 참고치이며, 우리 제품의 성과 지표가 아니다.
제품 한 줄
교재·시험지·프린트를 올리면 필기·낙서만 지우고 인쇄 원본을 복원하는 스캐너. OCR은 후속 단계로 두고, 1차 가치는 원본 픽셀 충실도에 둔다.
왜 생성형 “통짜 편집”을 기본으로 두지 않았나
기획 비교에서 생성형 이미지 편집 API는 MVP가 빠르지만, 문서 전체를 재생성하며 인쇄 글자를 치환·변형할 수 있다. 그래서 권장 골격은 하이브리드였다.
경계 감지·원근 보정
필기 마스크 (고전 CV + 세그멘테이션)
마스크 안만 인페인팅 (기본 LaMa, 실패 시 TELEA 폴백)
마스크 밖 픽셀은 수정하지 않는다
이 문장이 전 아키텍처의 중심이다.
파이프라인에서 배운 안전장치
마일스톤 로그에 남은 실전 교훈을 짧게 옮긴다.
불확실 영역 표시 LaMa는 필기 아래 인쇄 글자를 “그럴듯한 오탈자”로 채워 넣을 수 있다. 충실도 OCR 게이트는 마스크 *안쪽*을 측정하기 어렵다. 그래서 복원 불확실 구간을 계약 필드와 앰버 하이라이트로 노출했다. “깨끗해 보이는 결과”보다 어디를 믿으면 안 되는지를 보여 주는 쪽을 택했다.
마스크 커버리지 상한 실스캔에서 오검출이 커지면 본문까지 지워진다. 커버리지 상한(의심 마스크)과 원본 보존 경로를 넣어, 파괴적 결과를 차단하는 실험을 했다. 로그상 오검출이 크게 줄고 본문 보존이 확인된 사례가 있다. 굵은 헤더 오검출·잔여 필기는 이후 과제로 남겼다.
데모와 mock을 섞지 않기 UI mock만으로는 “필기 제거가 안 된다”는 피드백을 재현할 수 없다. 워커 FastAPI 직결 로컬 데모 브리지를 두고 나서야 브라우저 e2e로 원자적 JSON 쓰기·폴링 내성 같은 결함을 잡았다.
계약(versioned job schema) UUID·상태 전이·soft error·uncertain_regions 등을 버전으로 고정하고, 구세대 산출물은 폐기 세대로 격리했다. UI·워커·QA가 같은 언어로 실패를 말하게 하려는 목적이다.
교육 현장 관점
학원 배치: 같은 시험지 PDF를 다시 쓰려면 “예쁜 복원”보다 “인쇄 동일성”이 먼저다.
학생 오답 노트: 필기 제거 후 OCR·문항 클립은 P1 이후 스토리다. 너무 일찍 묶으면 충실도 문제가 가려진다.
윤리: 저작권 있는 교재 스캔·재배포는 사용자 책임 영역이다. 도구는 복원 보조이며, 무단 배포를 권장하지 않는다.
지금 단계의 한계
Web MVP·로컬 워커 중심. Android 연속 촬영은 후속.
실스캔 다양성(조명·볼펜·형광펜·겹친 글씨)은 여전히 꼬리다.
“100% 원본 보존”을 마케팅 문장으로 쓰지 않는다. 대신 OCR diff 게이트·불확실 영역 같은 검증 장치를 제품 언어로 남긴다.
다음에 같은 스캐너를 만든다면
마스크 밖 불변식 테스트부터 자동화한다.
실패 UX(재시도·원본 다운로드·불확실 배지)를 모델 교체보다 먼저 둔다.
교육용 배치(여러 장 → PDF)는 충실도 리포트와 함께 출시한다.
필기 제거는 이미지 미화가 아니라 문서 신뢰 문제다. CleanScan 실험이 남긴 가장 큰 문장은 여전히 이것이다. 마스크 밖은 건드리지 않는다. 확신이 없으면 표시한다.
짧은 영상을 “한 번 생성”하는 도구는 많다. 어려움은 그다음이다. 장면이 이어져야 하고, 캐릭터·배경이 흔들리면 안 되며, 비용·승인·실패 재시도가 파이프라인 안에 있어야 한다. video-auto(Chained Video Studio) 작업은 그 문제를 에이전트 오케스트레이션 + Electron 도구 + 외부 생성기로 나눠 붙잡은 실험이다.
이 글은 출시 후기가 아니라, 로컬 저장소에 남은 운영 계약과 검증된 산출물 기준으로 적은 회고다. 성과 수치나 미공개 API 키는 쓰지 않는다.
한 줄로 말하면
코딩 에이전트가 지능(오케스트레이터·디렉터·리뷰어)을 맡고, Electron/Node는 도구와 상태만 제공한다. 미디어는 Grok Imagine, Google Flow(Gemini Flow), Kling 등 외부 제공자가 만들고, 이 앱은 체인(순서·게이트·체크포인트) 을 소유한다.
Sora는 경로에서 제외했다. 제공자 표는 README 기준으로 grokWeb / grokApi / geminiFlow / klingApi / klingFal / klingWeb이다.
두 개의 제어면
CLAUDE.md가 못을 박아 둔 경계가 있다.
일 · 하네스 · 진입점
멀티 씬 필름 제작 · Claude production skills · shot-studio (plan → assets → render → post)
Electron 앱 코드 변경 · 앱 개발 하네스 · AGENTS.md → harness manifest
유료·비가역 단계(렌더 등)는 shot-studio 승인 게이트 뒤에 둔다. shot-plan 등을 직접 호출해 게이트를 우회하지 않는다.
병렬로 OpenMontage 흡수형 /video 경로도 있다. research·prompts·QA는 팬아웃하고, last-frame 릴레이만 순차로 두는 하이브리드다. 보드·체크포인트·코스트 스크립트(om:*)가 “지금 어느 스테이지인지”를 사람에게 보여 준다.
실제로 남긴 것
문서에 적힌 검증 산출물 예시는 다음과 같다.
최종 컷: runs/chain/black-file-twelve-faces/out/...-final-cut.mp4
프로덕션 레저: 同 프로젝트 ledger.json
편집 가능한 타이틀 AEP
두 번째 검증 레저: runs/chain/skyduel/ledger.json
즉 “데모 GIF 한 장”이 아니라, 런 디렉터리 + 레저 + 게이트가 남는 구조를 목표로 했다.
스토리 → 영상 E2E는 대략 이런 명령으로 묶인다.
npm run produce -- --story "..." --scenes 6 --yes --provider grokWeb
npm run produce:status -- --project <projectId>
npm run produce:stitch -- --project <projectId>
Three.js를 본선으로 쓰지 않은 이유
선택지 제목에 “Three.js 렌더”가 있었지만, video-auto 본 저장소의 중심은 생성형 비디오 체인 + ffmpeg 스티치 + 에이전트 게이트다. Three.js/WebGL 언급은 관련 학습 스펙 문서에 스치듯 나타날 뿐, 프로덕션 경로의 기본 렌더러로 고정되어 있지 않다. 회고에서 과장하지 않기 위해 본선은 체인 자동화로 적는다.
배운 점
파이프라인 없는 생성은 재현되지 않는다. Rule Zero — 모든 프로덕션은 manifest 스테이지를 탄다.
병렬과 순차를 섞어야 한다. 이미지·리서치는 병렬, 컷 연속성(릴레이)은 순차.
비용·연속성 게이트를 스킬 밖에 두면 반드시 우회된다. 진입점을 shot-studio 하나로 모은 이유다.
사람에게는 보드가 필요하다. dry-run·gate·ship 샘플이 온보딩을 대신한다.
캐릭터/월드 락 없이 씬을 늘리면 얼굴과 소품이 먼저 붕괴한다.
한계
브라우저 로그인 기반 제공자(grokWeb 등)는 세션·UI 변경에 취약하다.
외부 API 요금·쿼터는 레저로 추적해도 “창작 품질”을 보장하지 않는다.
Electron 앱 UX와 에이전트 스킬이 이중으로 있으면, 문서가 어긋날 때 드리프트가 생긴다. 변경 이력표를 CLAUDE/AGENTS에 남긴 이유다.
다음에 같은 일을 한다면
스토리 입력 → plan-only로 SCENE_TABLE 승인 → 그다음 gen.
provider는 한 프로젝트에 하나만 기본값으로 고정하고, 폴백은 명시적 게이트 뒤에.
최종물은 mp4만이 아니라 ledger + review 아티팩트를 함께 아카이브.
영상 자동화의 핵심은 모델 이름이 아니라, 에이전트가 같은 계약을 다시 실행할 수 있는가에 있었다.
코딩 에이전트에게 “예쁜 UI”를 맡기면 결과는 매번 조금씩 달라진다. 같은 브랜드인데도 버튼 색, 여백, 타이포가 세션마다 흔들린다. google-design-2026 작업에서 붙잡은 질문은 단순했다. 디자인을 에이전트가 다시 읽을 수 있는 하나의 문서로 고정할 수 있는가?
이 글은 Google의 DESIGN.md 형식과, 그 스펙을 Tailwind 테마·토큰으로 옮긴 로컬 워크플로를 정리한 회고다. 제품 출시 공지가 아니라, 실제로 무엇을 남기고 무엇을 버렸는지에 초점을 둔다.
DESIGN.md가 하려는 일
DESIGN.md는 시각 아이덴티티를 코딩 에이전트에게 설명하기 위한 포맷이다. 파일은 두 층으로 나뉜다.
공식 README의 요지는 명확하다. 토큰은 정확한 값을 주고, 산문은 적용 방식을 준다. 에이전트가 이 파일을 읽으면 “딥 잉크 헤드라인 + 따뜻한 석회 배경 + 단일 액센트 CTA”처럼 한 세트의 판단으로 UI를 맞출 수 있다.
철학 문서가 더 강하게 말하는 지점도 있다. 문장(의도)의 질이 숫자 정밀도보다 생성 품질을 좌우한다. “모던하고 신뢰감 있는 프리미엄” 같은 형용사 나열보다, “오래된 대학의 대학원 세미나 유인물”처럼 구체적 참조 한 줄이 여백·잉크·장식 금지를 함께 실어 나른다. 무엇을 빼는지가 캐릭터를 만든다.
로컬에서 한 일 (워크플로)
로컬 design.md 모노레포는 CLI·린터·예시(DESIGN.md + Tailwind config + DTCG JSON)를 한곳에 두었다. 실무에서 반복한 흐름은 대략 이렇다.
의도 먼저 쓰기 — Overview에 참조 세계와 Don’ts를 적는다.
토큰을 프론트매터에 고정 — primary/secondary/neutral, 타입 스케일, spacing.
npx @google/design.md lint — 깨진 참조, 구조, WCAG 대비 등을 JSON finding으로 받는다.
Tailwind로보내기 — 예시처럼 tailwind.config / design tokens JSON으로 옮겨 유틸리티가 같은 이름을 쓰게 한다.
diff로 회귀 감지 — 토큰·산문 변경이 “조용한 브랜드 붕괴”인지 확인한다.
중요한 운영 규칙 하나: 토큰을 “렌더 명령서”로 과대 해석하지 않는다. 스펙 쪽 관점도 토큰은 맥락이고, 산문이 디자인이다. Tailwind는 그 맥락을 빌드 타임에 붙잡는 다리일 뿐이다.
잘 된 점
세션 간 드리프트가 줄었다. 에이전트에게 “이 DESIGN.md를 따르라”고 하면, 색·타입의 중심이 문서에 남는다.
리뷰 언어가 생겼다. “느낌이 다르다” 대신 lint finding·token diff로 말할 수 있다.
예시 세트(예: Atmospheric Glass)가 온보딩을 짧게 만든다. DESIGN.md → Tailwind → DTCG JSON이 한 폴더에 있으면 설명 비용이 떨어진다.
깨진 점 / 주의
형용사만 채운 DESIGN.md는 무용하다. lint를 통과해도 산문이 비면 결과물은 다시 중간값 UI로 돌아간다.
컴포넌트 토큰을 Tailwind에 전부 밀어 넣으면 유틸리티 철학과 충돌한다. 예시 README도 컴포넌트 토큰은 JSON 쪽에 두고, Tailwind는 프리미티브에 집중하는 편을 택한다.
에이전트는 Don’ts를 잊기 쉽다. 산문에 금지를 쓰고, 체크리스트로 한 번 더 고정하는 편이 안전하다.
이 글은 Google 공식 제품 로드맵을 대변하지 않는다. 로컬에서 스펙을 읽고 적용해 본 작업 노트다.
다음에 남길 체크리스트
Overview에 구체적 참조 세계가 있는가.
색·타입·spacing 토큰 이름이 산문과 같은 어휘인가.
lint를 돌렸고, 대비·깨진 참조를 처리했는가.
Tailwind theme이 프론트매터와 이름 단위로 맞는가.
변경 시 diff로 회귀를 남겼는가.
디자인을 “예쁜 스크린샷”이 아니라 에이전트가 다시 실행할 수 있는 계약으로 두는 것. DESIGN.md → lint → Tailwind 연결은 그 계약을 짧고 검증 가능하게 만드는 한 가지 방법이었다.
[ ] AI chips are very cheap and easy to find. (False)
[ ] Companies are using AI to help them work faster. (True)
[ ] “Agentic AI” means AI can do tasks by itself. (True)
[ ] In 2026, nobody uses AI for shopping. (False)
🗣️ Advanced Vocab
Ecosystem: A complex network or interconnected system.
Autonomous: Having the freedom to govern itself or control its own affairs.
Infrastructure: The basic physical and organizational structures needed for operation.
Adoption: The action or fact of choosing to take up, follow, or use something.
Productivity: The effectiveness of productive effort, especially in industry.
LEVEL 1 (Kinder)
AI Brains Get Bigger 🧠
Computers need a brain to think. The brain is called a chip. Companies are making stronger chips so computers can be smarter!
LEVEL 2 (Kids)
The Great AI Chip Race 🏃♂️💨
Companies like Nvidia and Broadcom are making super-fast chips for AI. These chips allow computers to learn and do amazing things. Because everyone wants them, big tech companies are trying to build their own chips too!
LEVEL 3 (Tech)
Semiconductor Market Surges 💻
The AI hardware boom shows no signs of slowing down in March 2026. Earnings reports from Nvidia and Broadcom highlight explosive demand for custom AI accelerators and networking hardware. In response to supply shortages, hyperscalers like Google and Meta are accelerating the development of their own proprietary silicon to secure infrastructure dominance.
LEVEL 1 (Tech)
Helpful Robot Friends 🤖
AI is like a helpful friend. Now, it can do chores by itself. You can ask it to help, and it goes to work!
LEVEL 2 (Tech)
AI Agents Take Charge! 🕵️♀️
A new type of AI called the “Agentic AI” is becoming very popular in 2026. Instead of just answering questions, these AI agents can plan and do whole tasks on their own, like organizing your homework or managing a store’s supplies.
LEVEL 3 (Enterprise)
Rise of the Agentic AI 🚀
Agentic AI has evolved from a buzzword to business reality. By 2026, multi-agent systems are fully deployed across enterprise workflows. These autonomous systems can reason, execute complex multistep processes, and adapt to changing environments, significantly augmenting human operations in software development and global supply chain management.
LEVEL 1 (World)
New Ways to Work 👩💻
Adults go to work every day. Now, they use AI to help them. It makes their jobs faster and more fun.
LEVEL 2 (World)
How AI is Changing Jobs 💼
The government and big businesses are talking about how AI is changing the way we work. People need to learn new skills to use AI computers. Universities are even making new “AI Majors” so students can learn all about it!
LEVEL 3 (Society)
Workforce Transformation 🌐
The integration of AI into the global workforce is prompting major policy shifts. Governments are hosting academies to discuss AI’s impact on employment, while universities are rapidly deploying AI-focused curricula. The mandate for 2026 is clear: upskilling workers to collaborate effectively with intelligent systems is an economic necessity.
LEVEL 1 (Tech)
A Big Box of Knowledge 📦
AI needs to remember lots of things. It uses a big box called a database to keep all the information safely.
LEVEL 2 (Tech)
Powering AI with Data 📊
Apps that use AI need to handle a huge amount of messy information. Companies like MongoDB provide special online services to store and sort this data quickly, so the AI can find exactly what it needs to answer your questions.
LEVEL 3 (Dev)
Unstructured Data Demand 📈
Cloud database providers like MongoDB are experiencing record growth, driven largely by the demands of AI application development. The critical need to ingest, process, and retrieve vast amounts of unstructured data for RAG (Retrieval-Augmented Generation) pipelines has positioned robust data infrastructure as the backbone of modern AI solutions.