
TypeSafe AI의 Jev는 긴 문장을 생성하는 채팅 모델이 아니라, 프로그램 상태(state)와 타입 있는 질문을 받아 선택·점수·예/아니오 확률을 돌려주는 System One 모델이다. 이 글은 공개 실전 가이드 How to Use Jev: A practical guide to TypeSafe’s System One model의 구조를 바탕으로, moonlang에 이미 올린 소개 초안(WP 1704)과 공식·언론 교차 확인 범위 안에서 설정·세 프리미티브·다섯 패턴·실패 모드·언제 쓸지만 정리한다.
숫자 주의. 지연·가격 배수·벤치마크·“출시 48시간 데모” 비용은 대부분 TypeSafe 또는 데모 작성자 보고다. 가이드 본문도 자사 측정·미재현을 전제로 한다. 아래에서는 그 한계를 반복해 표시한다.
한 줄로
Jev는 state + 질문(Choice / Score / Noul)을 한 요청에 넣고, 수십~수백 밀리초 구간의 구조화 답을 받는 쪽에 가깝다. 텍스트·코드·요약을 “쓰게” 하는 도구가 아니다. 싸게 분류·라우팅·게이트한 뒤, 필요한 소수만 큰 LLM이나 사람에게 넘기는 캐스케이드가 실무 기본형이다.
Setup (가이드 기준)
키는 console.typesafe.ai/settings/keys(early access·웨이팅 가능) 또는 Vercel AI Gateway 경로를 가이드가 안내한다.
export TYPESAFE_API_KEY="sk-..."
- Python 3.10+:
pip install typesafe-sdk(또는uv add typesafe-sdk) - Node 20+:
npm install @typesafe-ai/sdk
가이드 기준 기본 모델은 jev-latest, HTTP는 POST https://api.typesafe.ai/v1/systemone. 패키지명·환경 변수명은 배포 시점에 바뀔 수 있으니 공식 문서와 콘솔을 한 번 더 확인한다.
회사·게이트웨이 쪽에 반복되는 입력 단가는 약 $0.042 / 1M input tokens, 출력 토큰 무료 주장이다. (Vercel AI Gateway 모델 카드·공식 소개와 동일 계열. 지속 가능 여부는 회사가 “장기 과제”로 남긴 바 있다.)
세 프리미티브
API의 질문 타입은 세 가지가 전부다. 우회할 제한이 아니라 설계 자체다. (공식 Primitives 문서와 동일 계열)
Choice — 집합에서 하나
Choice(
    instructions="Which team should handle this",
    criteria={
        "billing":   "Payment or subscription issues",
        "technical": "Bugs or integration problems",
        "sales":     "Pricing or account questions",
    },
)
.choice, .probabilities, .confidence를 돌려준다. 가이드는 옵션을 최대 255개까지, 짧은 숏리스트보다 전체 목록을 넘기라고 한다. 맞는 게 없을 때를 위해 명시적 other를 넣으라고 권한다.
Score — 스펙트럼 위 위치
Score(
    instructions="How frustrated the customer appears",
    criteria=[
        "Calm, just stating facts",
        "Frustrated but civil",
        "Very angry, strong language",
    ],
)
2~10단계의 순서 있는 수준. .score는 단계 사이 값(예: 1.035)이 될 수 있고, 단계 인덱스는 배열 순서(0부터)다.
Noul — 예/아니오를 확률로
Noul(instructions="The message conveys urgency or time-sensitivity")
.noul은 0~1. 가이드 기준으로는 별도 confidence 필드가 없고, 숫자 자체가 믿음의 표현이다.
한 요청에 묶기
from typesafe_sdk import Choice, Noul, Score, TypeSafeClient

client = TypeSafeClient()
response = client.system_one(
    state={
        "ticket": {
            "subject": "Duplicate charge",
            "messages": [
                {"from": "customer",
                 "text": "I was charged twice for order A-104. Please refund the duplicate."},
            ],
        },
        "order": {"id": "A-104", "charges": [
            {"amount_usd": 49, "status": "captured"},
            {"amount_usd": 49, "status": "captured"},
        ]},
        "refund_policy": "Duplicate charges are eligible for a refund.",
    },
    questions={
        "department": Choice(
            instructions="Which team should handle this",
            criteria={"billing": "Payment or subscription issues",
                      "technical": "Bugs or integration problems",
                      "sales": "Pricing or account questions"}),
        "frustration": Score(
            instructions="How frustrated the customer appears",
            criteria=["Calm, just stating facts",
                      "Frustrated but civil",
                      "Very angry, strong language"]),
        "refund_requested": Noul(
            instructions="The customer is explicitly asking for a refund"),
        "policy_supports": Noul(
            instructions="The stated refund policy covers this situation"),
    },
)
TypeScript 가이드 예시도 같은 모양이다. state는 문자열·객체·문자열 배열. 이미지·오디오·비디오는 없고, 필요하면 먼저 전사·캡션한다. 가이드가 적는 컨텍스트 한도는 대략 state+질문 합 64k, state+가장 긴 질문 32k 토큰(문서·버전과 다를 수 있음).
훔칠 만한 다섯 패턴
1) Speculative fan-out
질문은 병렬이라, “싼 호출 먼저 → 필요할 때만 후속” 본능을 뒤집는다. 카테고리와 무관해 보이는 후속 질문도 같이 묻고, 코드가 어떤 답을 쓸지 고른다. 가이드가 인용하는 TypeSafe 쿡북 주장: 위키 장문 위에 13질문을 한 번에 묶으면, 하나씩 물을 때보다 약 12.2× 싸고 10.0× 빠르며 답은 동일 — 자사 쿡북 수치다.
2) Confidence-gated routing
가이드는 Jev가 RLCD(Reinforcement Learning for Calibrated Decisions)로 확률을 결과에 맞춘다고 설명한다. (공식 소개는 보정된 결정 학습을 채팅용 RLHF와 대비한다.) 그래서 전역 임계값 하나보다, 행동 비용별로 다른 막을 둔다. 잔액 조회는 낮게, 이체 승인은 높게. 분포가 평평하면 모델보다 criteria 설계 문제인 경우가 많다.
3) Composite scoring
“이 지원자 얼마나 좋은가” 한 방 대신, 파이썬 깊이·리더십·시스템 설계처럼 원자 Score를 나눈 뒤 가중 평균은 코드에서 한다. 가중치 변경이 재프롬프트가 아니라 코드 변경이 된다.
4) Cascade
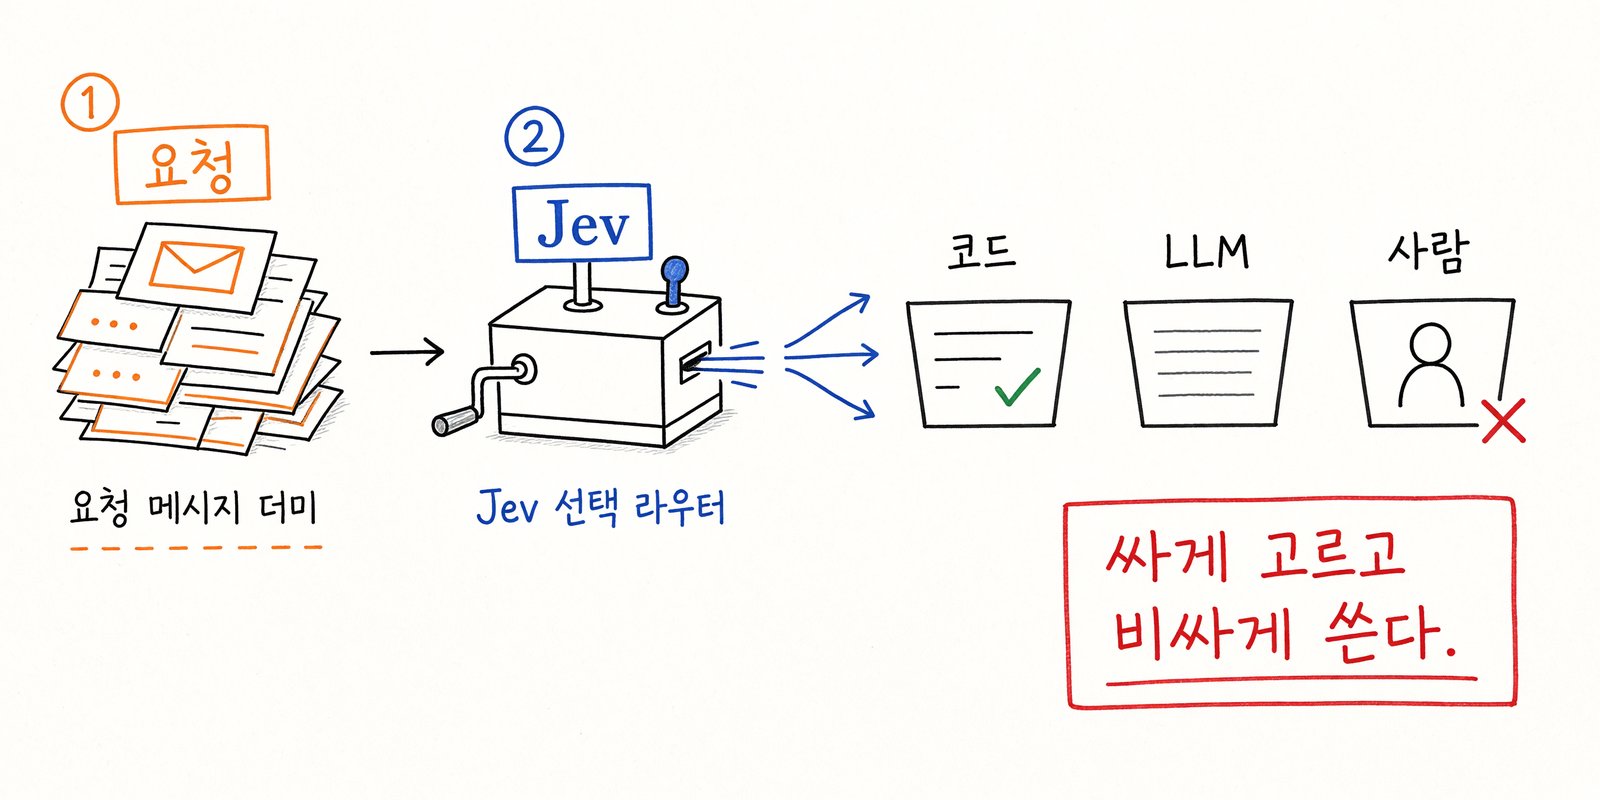
Jev는 Opus/GPT급을 대체하지 않는다. 누가 큰 모델을 받을지를 값싸게 고른다. intent+complexity로 나눈 뒤, 순수 코드 / 전문 LLM / 사람 에스컬레이션으로 분기. 가이드의 백만 티켓 비용 예시($6,480 vs $30,400 등)는 TypeSafe per-case 가정에 따른 산술 — 재현·트래픽 전제 없이 그대로 믿으면 안 된다.
5) Retrieve, then judge
Jev는 넘겨준 state 밖의 세계를 모른다. 관련 없는 텍스트를 넣으면 정확도가 떨어진다고 jaggedness/문서 계열에서 경고한다. 검색·필터는 코드(또는 검색 API)로 하고, 논문·패시지마다 Noul/Score로 값싼 판정만 맡긴다. “잘 보정된 잘못된 자료에 대한 판단”이 나올 수 있다.
출시 직후 데모 (참고만)
가이드는 2026-09-15 론칭 이후 약 48시간 산출물을 모았다. 작성자 자기 보고이며 프로덕션 사례가 아니다. 패턴만 요약한다.
- 대량 논문: 생성 모델로 요약 + Jev Choice로 토픽 분류(비용 비대칭을 보여 주는 파이프라인).
- 브라우저/컴퓨터 사용: 페이지·OCR을 기호 상태로 압축한 뒤 Jev가 행동·타깃을 고르고, 텍스트 입력 등만 작은 생성 모델.
- 트레이딩·드론 등: 제어 루프·안전은 코드, Jev는 낮은 Hz의 전술 판단만.
공통점: 루프·안전·산술은 평범한 코드에 두고, 코드로 쓰기 어려운 좁은 판단만 Jev에 둔다.
실패 모드 (가이드·jaggedness 계열)
- 글자 그대로 읽는다. 부정·범위·암시 조건이 곧이곧대로 적용된다. 틀린 답을 보고 “내가 진짜 뜻한 말”을 설명하게 되면, 그 설명이 빠진 instruction이다.
- 계산기가 아니다. 세기·날짜 순서·창 안 여부 등은 약하다. 항목마다 Noul을 돌리거나, 날짜는 열거 Choice + “미기재”, 조립은 코드.
- Context rot. 질문에 필요 없는 state가 늘수록 성능이 떨어진다. 먼저 회수·필터.
- 적대적 state. 사용자 통제 텍스트가 스스로를 변호하면 답이 움직인다. 위협 모델은 애플리케이션 몫.
- 모순된 criteria. true가 “아니오”를 뜻하는 Noul 등은 약해진다.
- 생성 없음. 텍스트·코드·요약 불가. 후보는 정규식/생성 모델로 뽑고 Jev가 고른다.
메타 규칙: 코드가 정확히 계산할 수 있는 것을 모델에 묻지 말고, 한 질문에 여러 판단을 숨기지 말 것.
운영 메모 (가이드 시점)
- 레이트 리밋 예시: jev-1.13 기준 초당 토큰·분당 요청 상한과 429 + SDK 백오프 — 용량에 따라 예고 없이 변할 수 있다고 TypeSafe가 경고.
- 임계값을 튜닝했다면
jev-latest대신 버전 핀. 응답의 model 필드를 로그. - 과금은 입력 중심·출력 무료 주장이라 speculative fan-out이 싸다는 논리다.
정직한 스코어카드
가이드가 인용하는 TypeSafe 4-워크플로 평가에서 Jev가 일부 프론티어와 비슷한 합의 점수·훨씬 낮은 비용/지연을 주장한다. 다만 (1) 정답이 아니라 두 프론티어 평균 레이블과의 합의도, (2) TypeSafe가 설계·실행한 자사 평가, (3) “환각 0%”는 스키마 밖 값을 못 낸다는 뜻이지 틀린 valid 답을 안 낸다는 뜻이 아님, (4) 가격 지속성은 증명되지 않음. 우리 트래픽으로 다시 재야 한다.
언제 쓰고 / 언제 안 쓰나
맞음: 라우팅·트리아지, 모더레이션, 비싼 컨텍스트 전 관련성 필터, LLM 출력 가드레일, 초저가 대량 태깅, 요청 핸들러 안 서브세컨드 판정.
아님: 생성 전반, 산술·카운트·날짜 연산, 감사 추적용 서술 근거가 필요한 결정, 열린 답 공간, 일회성 복잡한 추론.
싸진 LLM이 아니라, 타입을 반환하고 신뢰도를 말하는 함수 호출에 가깝다. 문자열 출력을 견디려고 쌓아 둔 파서·재시도 상당수를 걷어낼 수 있는지가 핵심 질문이다.
교육·문해력 쪽에서 보면
수업용 채팅봇 대체가 아니다. 다만 “한 방에 총평” 대신 기준을 Choice/Score/Noul로 쪼개고, 임계값 아래에서 사람이 개입하는 구조는 읽기 교육의 근거·판단 분리와 닮아 있다. 학생 산출물 자동 채점도 동일하게 문항 단위 판정 + 사람 게이트가 더 안전하다.
체크리스트
- 일이 유한 옵션·척도·예/아니오로 쪼개지는가.
- 틀린 결정을 잡을 임계값·에스컬레이션이 코드에 있는가.
- 산출물이 문장 자체면 LLM이 맞다.
- state는 최소·근거 있는 소스만 — 검색은 앞에서.
- 가격·지연·한도는 PoC와 게이트웨이 카드로 재확인. early access·모델 버전 변경을 전제한다.
출처
- 실전 가이드 원문 구조: How to Use Jev: A practical guide to TypeSafe’s System One model (사용자 제공; ai/llm/tutorial 태그)
- 공식: typesafe.ai, Introducing System One Models & Jev (2026-09-15), docs.typesafe.ai
- 교차: Business Wire / SiliconANGLE / Forbes The Prompt / The Register (2026-09-15~16), Cloudflare Workers AI·Vercel AI Gateway 모델 카드
- 관련 moonlang 초안: TypeSafe AI와 Jev 소개 (WP 1704, draft)