한국어 관용구 220항목 × 5포맷: 학습 자료 뱅크를 만든 이유
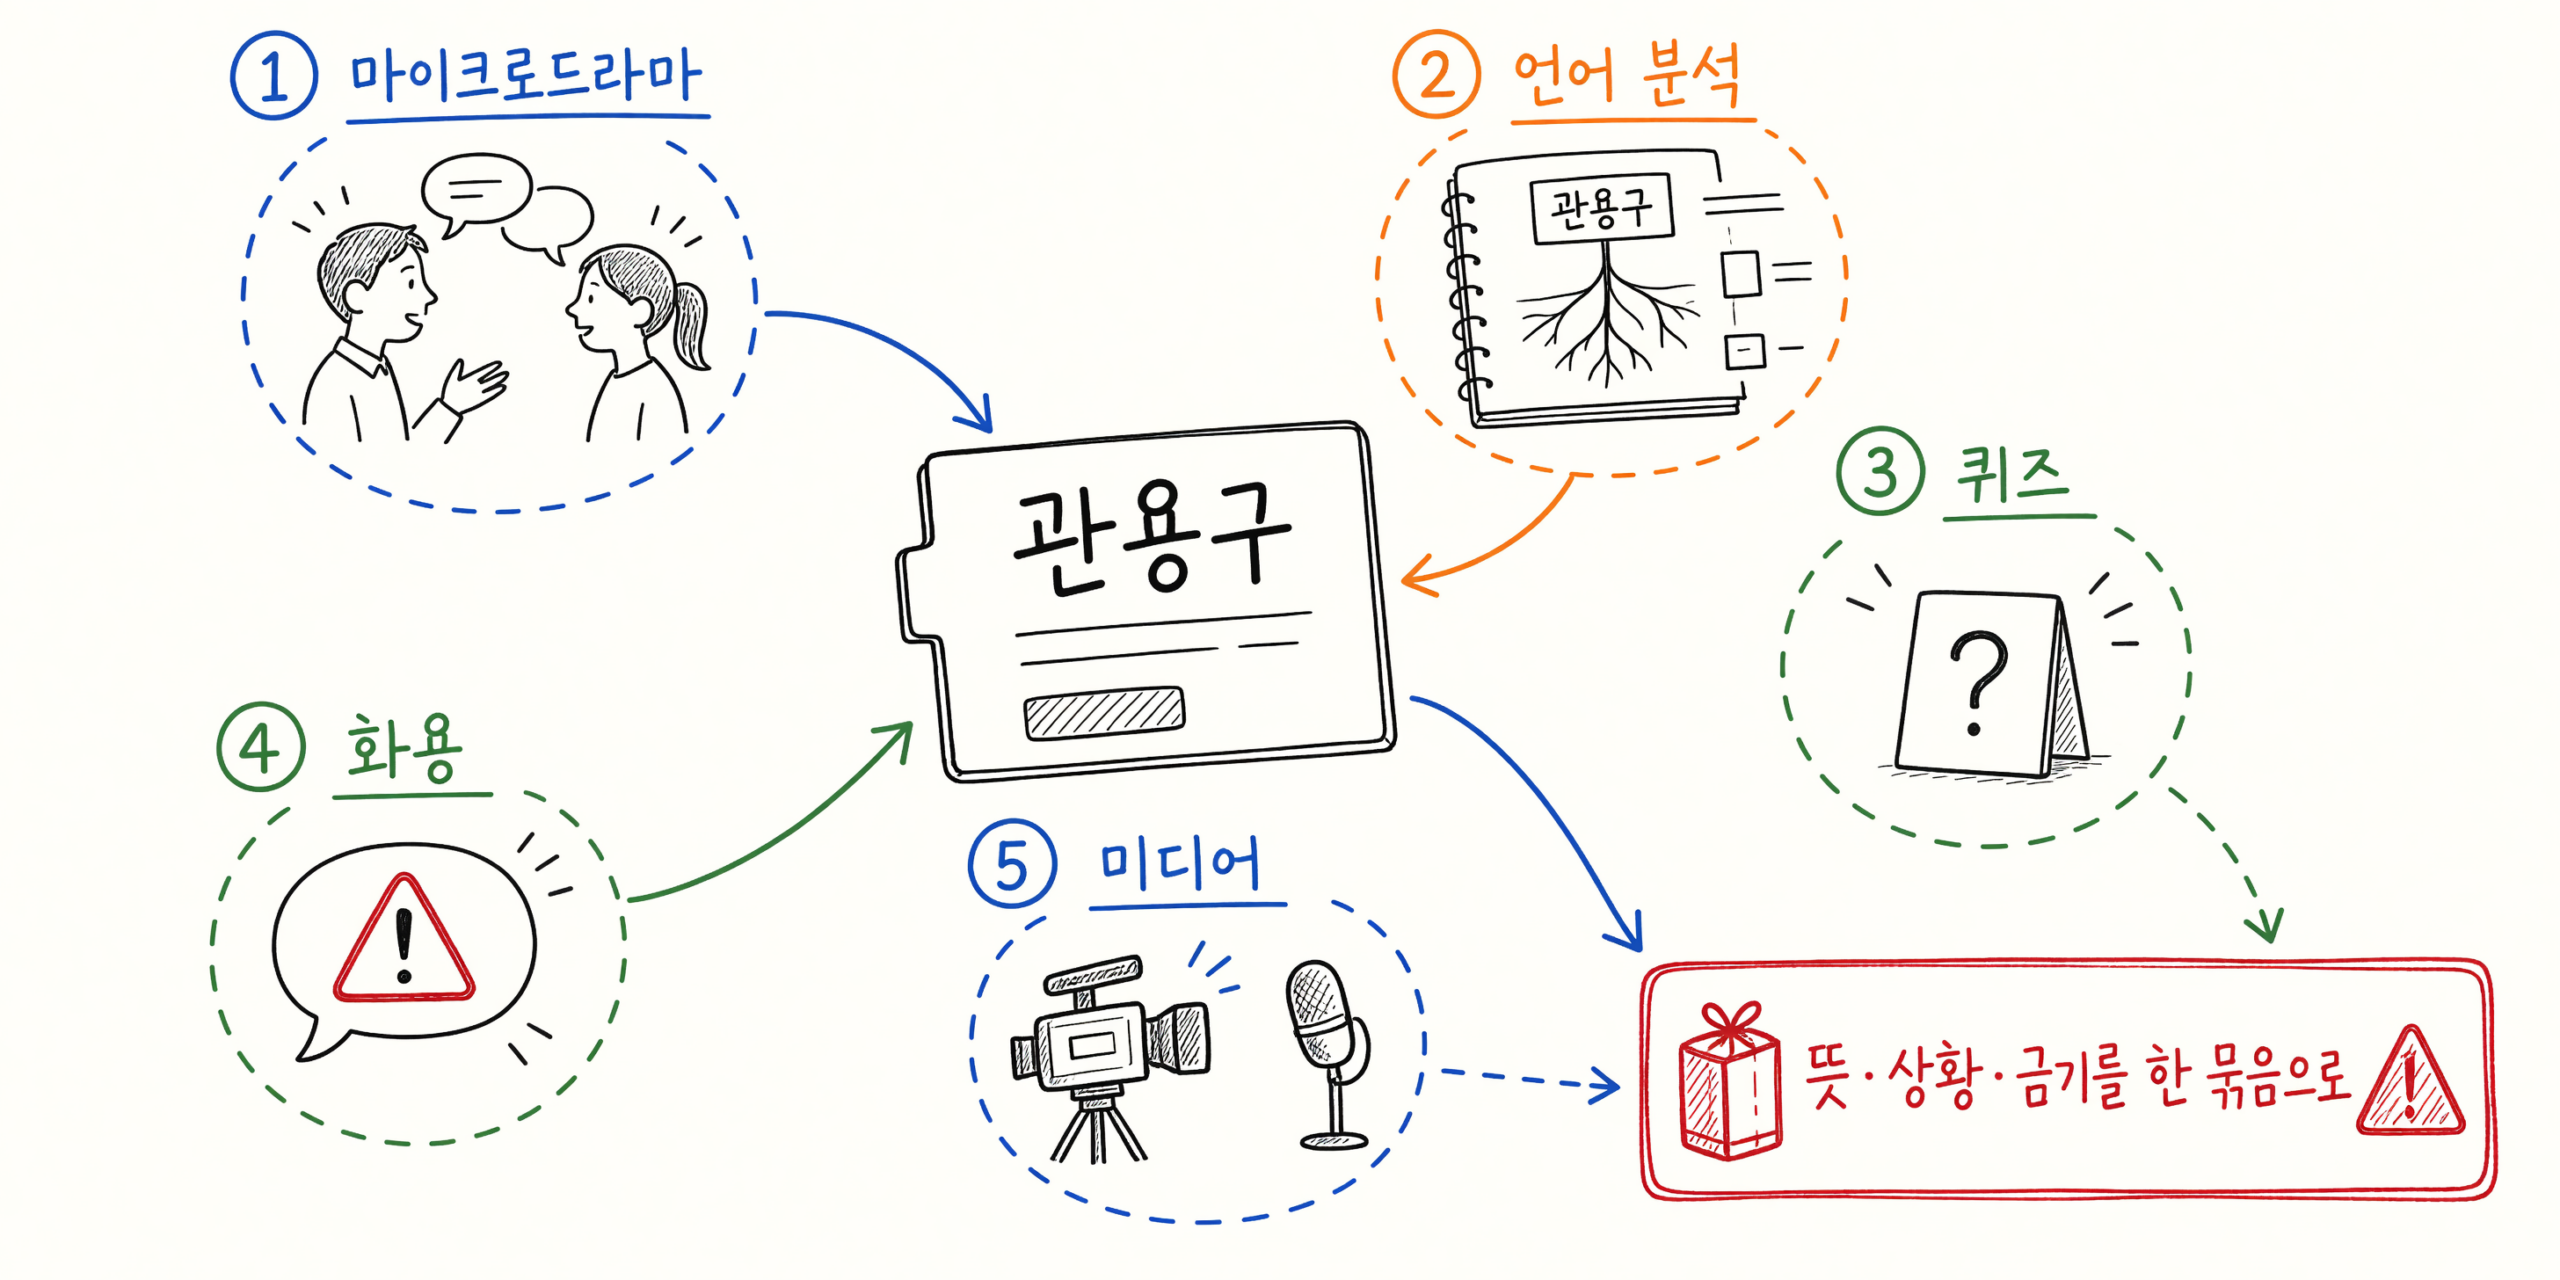
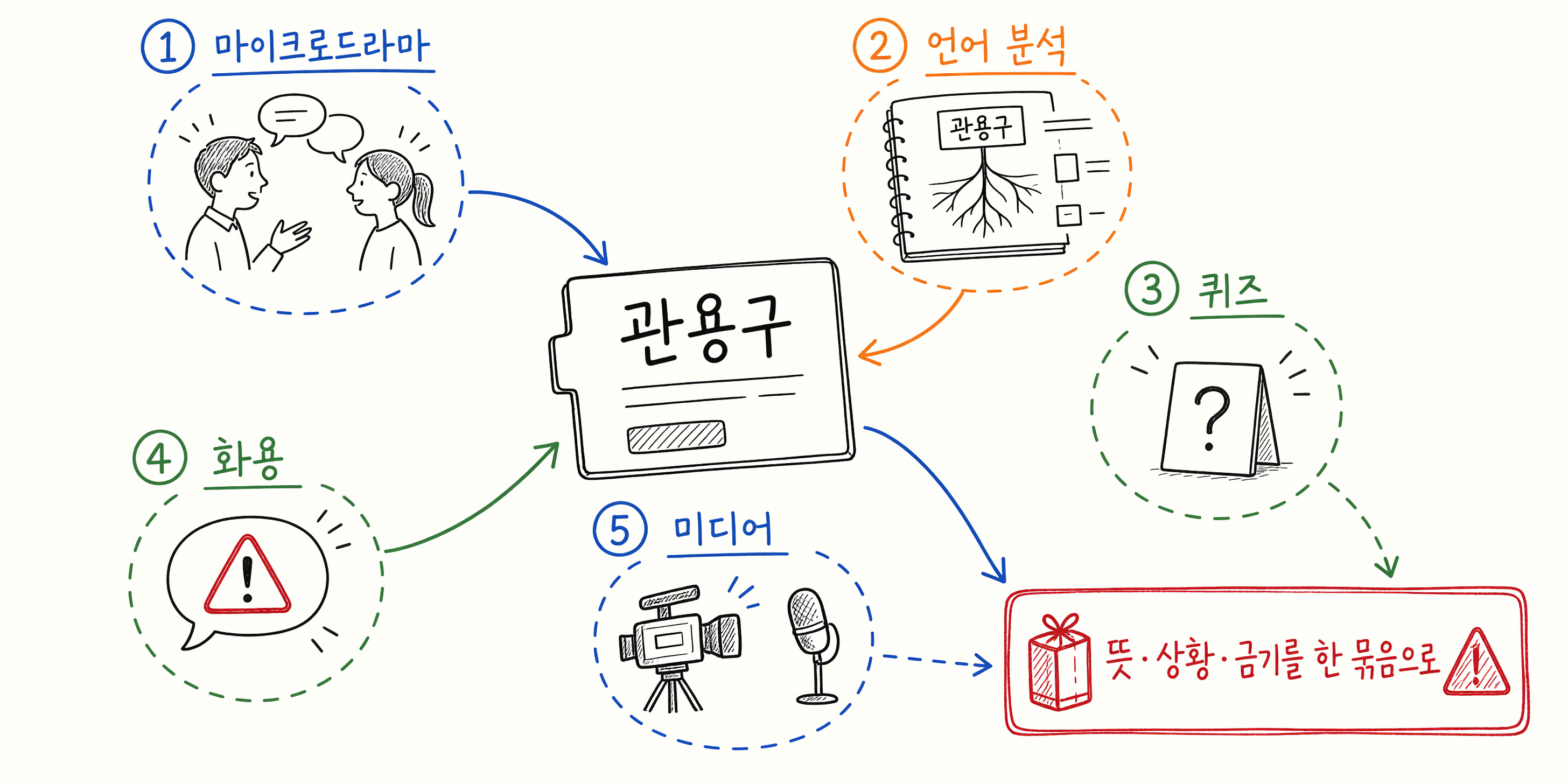
외국인 학습자에게 속담·관용구를 “뜻 한 줄”로만 주면, 시험에서 고를 수는 있어도 대화에서 쓰지 못한다. 반대로 예문만 잔뜩 있으면 핵심 의미와 금기(언제 쓰면 失礼인지)가 묻힌다. korean-idioms 프로젝트는 그 간극을 메우기 위해, 항목마다 같은 스키마의 다섯 포맷을 묶은 콘텐츠 뱅크를 만들었다.
이 글은 공개 가능한 구조와 설계 원칙만 정리한다. 개별 문항 전문을 여기에 복제하지 않는다.
무엇이 쌓였는가
README 기준 규모는 다음과 같다.
- 220개 표제어 (속담 84 · 관용구 56 · 사자성어 40 · 의성·의태어 40)
- 표제어당 5포맷: 마이크로드라마 · 언어 분석 · 퀴즈 · 화용(쓰임) · 미디어 제작 사양
- 합쳐 텍스트 자산 약 1,100개 단위 (대본 턴·문항·분석 카드·화용 노트·미디어 스펙을 포함)
앱은 Next.js로 번들(workspace/bundles/*.json)을 읽고, Supabase 키가 있으면 DB로 전환한다. 키가 없어도 로컬 번들로 동작하게 해 두었다.
왜 ‘한 사전 항목’이 아니라 ‘5포맷 번들’인가
학습자가 실제로 막히는 지점이 포맷마다 다르기 때문이다.
포맷 · 학습자가 얻는 것
마이크로드라마 · 상황·말차례 안에서 표현이 나오는 감각
언어 분석 · 구성, 유의·반의, 함정(literal trap)
퀴즈 · 이해 점검 (정답만 외우지 않도록 설계)
화용 · 누가·언제·얼마나 공손한지, 피해야 할 맥락
미디어 사양 · 이미지·TTS 등 후속 제작을 위한 텍스트 스펙
예: 「가는 말이 고와야 오는 말이 곱다」는 뜻이 쉬워 보여도, 직역 함정과 사용 역(register)을 같이 적지 않으면 “그냥 착하게 말하자” 수준으로 납작해진다. 번들 필드에 literal_trap, register, caution 등을 둔 이유다.
설계 원칙 두 가지
1) 주의 항목은 삭제하지 않고, 맥락과 함께 남긴다. 계급·체념을 정당화해 온 이력이 있는 속담은 다섯 포맷 모두에 “옛 표현이며 오늘날에는 반박·주의가 따른다”는 정보를 넣는다. caution_note가 비면 마스크·검증에서 거부되도록 했다. 검열이 아니라 설명 책임에 가깝다.
2) unresolved는 실패가 아니라 정직성 기록이다. 실사용 빈도를 확신할 수 없거나, 어원을 지어내고 싶지 않거나, 원어민도 잘 구분해 쓰지 않는 쌍은 억지로 “정설”을 만들지 않고 unresolved로 남긴다.
생성 파이프라인은 레인(lane) 출력 → 마스크 감사 → reduce 병합 → Zod 검증 순이다. 미디어 실물화(이미지·TTS)는 별도 하네스(idiom-media-realize)로 분리했고, 파일럿은 일부 항목(KI-001~005)부터 이미지를 붙이는 방식으로 진행했다.
교실·자습에서 쓰는 법 (제안)
- 의미 확인은 언어 분석 카드만 보지 말고, 마이크로드라마 한 장면을 먼저 읽는다.
- 퀴즈는 틀린 보기 이유를 화용 노트와 대조한다.
- 주의 깃발이 있는 항목은 “시험용 뜻”과 “지금 말해도 되는 말”을 구분해 지도한다.
- 교육용으로 쓸 때는 번들을 그대로 대량 복제·재배포하지 말고, 필요한 항목만 수업 시트에 맞게 재구성한다.
이 글에서 하지 않는 말
- 수강 성과·점수 향상 보장
- 검증되지 않은 “원어민 사용 빈도 순위”
- 어원을 단정한 설화
관용구 교육의 난점은 데이터 양이 아니라, 뜻·상황·금기를 같은 묶음으로 유지하는 일에 있다. 220×5 뱅크는 그 묶음을 스키마로 고정해 둔 작업 기록이다.